NTE-016经验笔记CLASS · PUBLIC
给3090、4070和4090加个“Ti”:这几天的Tensor解锁小记
3090、4070、4090的部分Tensor指令吞吐接近翻倍。记下一个简单原理、我们的同卡对测,以及B站网友提供的应用测试参考。
- DATE
- 2026.10.27
- READ
- 4 MIN
- LENGTH
- 1,308 字
这几天最开心的事是:我们的3090、4070、4090先后完成解锁,短时数值检查也过了。于是它们在我们这儿有了新名字:3090 Ti、4070 Ti、4090 Ti。
这个“Ti”是自己封的,算个玩笑。卡还是原来那张卡,没有增加SM或显存,也没有刷成Ti的BIOS。真正变了的是一部分Tensor指令的吞吐:FP16/BF16输入、FP32累加这一档,短测接近原来的两倍。
原理:一句话加三步
一句话版本:消费级卡上的部分Tensor速率受到限制;在原驱动接管前调整相关状态,再交还原驱动使用。上游的逆向实现与解释见 Zagitta/gpu-unlock。
- 抢在驱动之前:Linux通过早期模块,Windows适配走UEFI阶段。
- 调整速率选择:修改SM相关的speed-select状态。
- 复位并交接:完成所需的FLR等初始化流程,再让原驱动接管。
思路很短,适配却不一定简单。板卡、显示拓扑、固件和启动路径都可能影响结果。Windows项目还是实验性适配,不是同型号通用的一键升级包;尝试前要留好原始启动入口和恢复办法。
我们自己的数字
下面是26日保存的同卡前后短时Tensor微基准,单位TF/s,显示值取两位小数。它测指令吞吐,不是游戏帧数或整套模型速度。4070使用同配置的近期配对记录,不混用更早批次的基线。
| 显卡 | 输入→累加 | 解锁前 | 解锁后 | 吞吐比 |
|---|---|---|---|---|
| RTX 3090 | FP16→FP32 | 80.19 | 157.92 | 1.97× |
| RTX 3090 | BF16→FP32 | 80.20 | 157.71 | 1.97× |
| RTX 4070 | FP16→FP32 | 63.46 | 126.31 | 1.99× |
| RTX 4070 | BF16→FP32 | 63.46 | 124.12 | 1.96× |
| RTX 4090 | FP16→FP32 | 162.58 | 320.73 | 1.97× |
| RTX 4090 | BF16→FP32 | 162.60 | 320.72 | 1.97× |
这些数字来自我们的记录,下面两张社区截图则是另一组证据,不能合并成同一套测试。
哪些计算吃得到
| 计算路径 | 本轮观察 |
|---|---|
| FP16/BF16输入、FP32累加 | 指令吞吐接近翻倍 |
| 所测Ada卡的FP8→FP32、TF32 | 同样受益,幅度依配置而异 |
| FP16累加、INT8 | 这轮指令吞吐基本不变 |
| 实际GEMM或完整工作流 | 取决于矩阵形状、计算路径及加载等开销 |
我们在Linux 4090上的GEMM短测里,4096³的FP16约提升18–28%,8192³约提升11–14%,4096³的BF16基本持平。吞吐上限解开了,应用到底能吃多少,要看它在忙什么。
B站网友的应用实测参考
以下为用户提供的B站网友截图,非本站测试;目前未取得可核对的原帖链接和作者名,因此只按截图所示条件讨论,不将数字视作我们的复现结果。
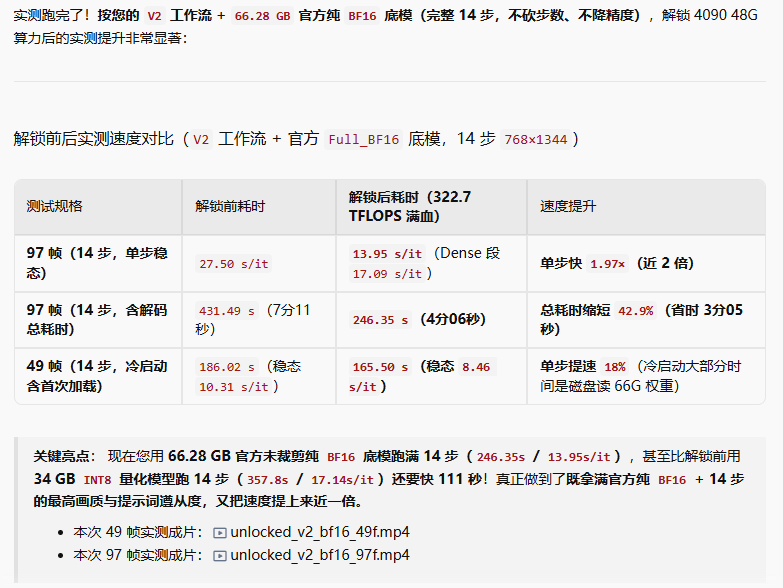
图1:B站网友实测,用户提供截图。图示为4090 48GB、完整14步、BF16底模工作流;不是标准24GB 4090的本站测试。点图查看原图。
截图里97帧任务的单步时间从27.50降至13.95秒,速度约为1.97×;含解码总耗时从431.49降至246.35秒,耗时缩短约42.9%。这两种说法分母不同,不应把“省时42.9%”写成“速度提升42.9%”。
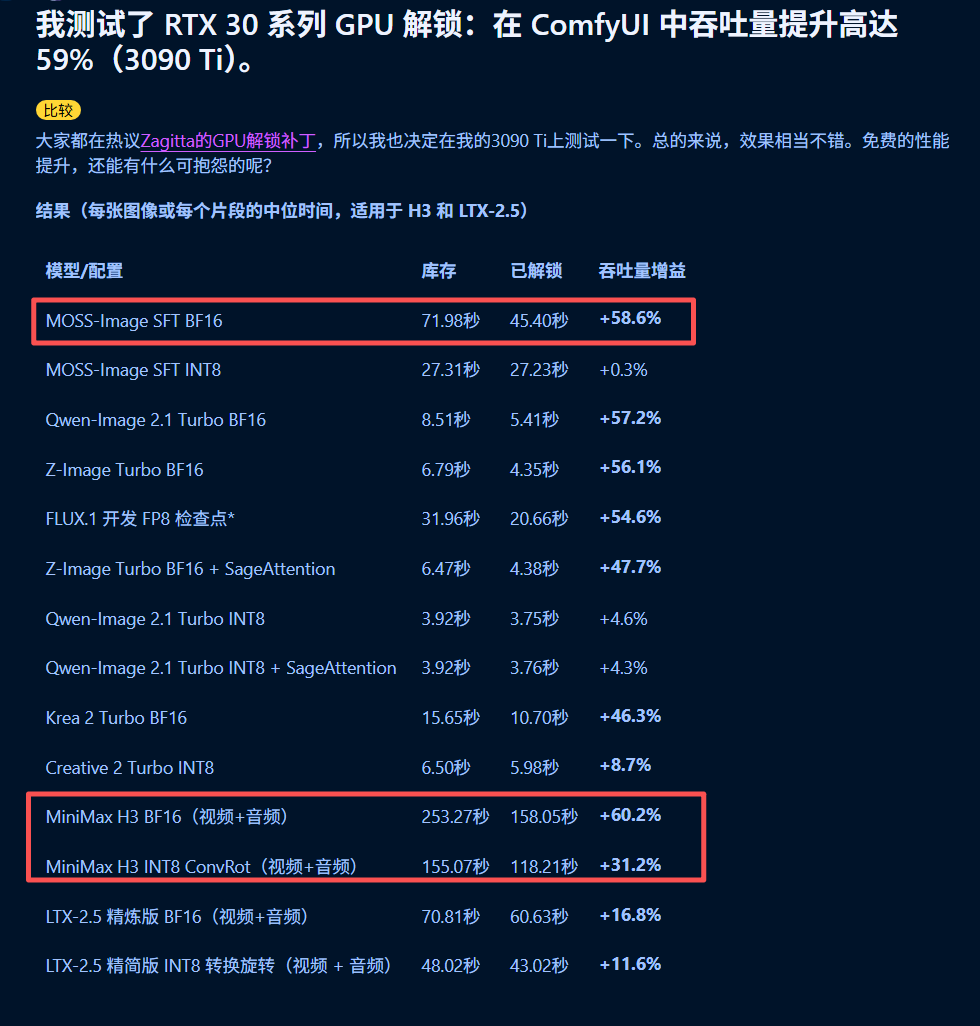
图2:B站网友实测,用户提供截图。截图标注RTX 3090 Ti,按原文型号保留,不冒称我们的3090;不同模型、量化与注意力路径的收益差别明显。点图查看原图。
例如图中的MOSS-Image SFT BF16为71.98→45.40秒,按前后耗时计算,吞吐约提升58.5%;同模型INT8则几乎没变。这也是这个解锁有意思的地方:不是所有负载一起涨,而是某些原本受限的路径突然能跑开了。
这次先庆祝到这里
- 三种卡已经完成解锁及短时吞吐、数值检查。
- Windows自动启动入口已配置;首次自动生效仍待实际重启验证,手动成功不代替自动成功。
- 我们自己的长期稳定性、真实模型端到端测试还没做,社区截图不能代替它们。
先给三张老伙计戴上引号里的“Ti”。不用换卡,就多出一截能用的计算空间,已经很值得开心了。
项目入口
以下均为社区项目,不是NVIDIA官方功能。先读适用硬件、风险和恢复说明,不照抄别人的固件配置。